3e partie : L'IA est-elle capable d'extraire avec précision des données d'urbanisme à partir des règlements de zonage ?
Dans la 1re partie de cette série d’articles en trois volets consacrée à la question de savoir si l’IA peut extraire avec précision des données d’urbanisme à partir des règlements de zonage, Jocelyn Tang, analyste SIG chez Esri Canada, a présenté le problème et examiné différents modèles de langage de grande envergure (LLM) afin de trouver celui qui conviendrait le mieux à cette tâche. Dans la deuxième partie, elle a exploré différents indicateurs à utiliser pour évaluer les LLM. Elle a également conclu que l’utilisation des LLM comme outil d’extraction d’informations à partir des règlements de zonage offrait une précision d’environ 70 %. Aujourd’hui, dans la dernière partie de la série, Jocelyn conclut son étude en affinant l’un des modèles qu’elle a utilisés dans la deuxième partie afin de déterminer s’il est possible d’améliorer les résultats.
Les modèles basés uniquement sur un encodeur nécessitent un ajustement spécifique au domaine pour améliorer leur précision. Dans la troisième partie de cette série d’articles de blog, je souhaite explorer le réglage fin et voir si je peux améliorer le score F1 du modèle pré-entraîné de réponse à des questions le plus performant identifié dans la deuxième partie (Robustly Optimized BERT Approach ou RoBERTa) en l’adaptant au texte des règlements d’urbanisme.
Ajustement fin ou pré-entraînement ?
On pourrait facilement penser qu’il n’existe qu’une seule façon d’entraîner des modèles d’IA. En réalité, il existe de nombreux types de méthodologies d’entraînement. Il est important de comprendre la différence entre le « fine-tuning » d’un modèle et le pré-entraînement d’un modèle de base ou « foundation model » à partir de zéro.
Pré-entraînement : il s’agit de la phase initiale de l’entraînement d’un LLM, au cours de laquelle le modèle ne dispose d’aucune connaissance préalable. L’objectif du pré-entraînement est de créer un modèle de base capable de comprendre le langage général (par exemple : GPT, Claude, RoBERTa et BERT). Le LLM est entraîné sur un ensemble de données volumineux et varié (souvent des milliards, voire des billions de tokens issus d’Internet, de livres et de code) afin de développer une compréhension globale du langage, du contexte et de divers types de connaissances. Ce processus est très gourmand en ressources informatiques et implique des quantités massives de données.
Ajustement : L'ajustement consiste à prendre un modèle de base déjà pré-entraîné et à le former davantage sur un ensemble de données plus spécifique. Les ensembles de données utilisés pour l'ajustement sont souvent spécifiques à un domaine. Cela permet au modèle ajusté d'obtenir de meilleures performances sur des tâches ou des scénarios spécifiques qui n'étaient pas bien couverts lors du pré-entraînement, par exemple : les diagnostics médicaux, des textes juridiques spécifiques ou des documents. L'affinage vise à améliorer les connaissances d'un modèle existant dans des contextes spécifiques plutôt qu'à élargir ses connaissances générales. Il est moins coûteux en termes de ressources informatiques et nécessite un ensemble de données bien plus restreint que le pré-entraînement.
Les règlements d'urbanisme constituent un ensemble de données spécifique à un domaine et, dans ce cas de figure, il est judicieux d'affiner un modèle pré-entraîné existant !
Pour en savoir plus sur ce sujet, consultez la documentation d'IBM consacrée à l'optimisation.
Méthodologies de mise au point
Il existe de nombreuses façons différentes d'affiner un modèle. Dans cet article de blog, je n'aborderai que quelques méthodologies clés.
L'ajustement supervisé (SFT) : il s'agit de la méthode d'ajustement la plus simple, qui donne les meilleurs résultats pour des tâches bien définies. Elle repose sur un ensemble de données composé de paires d'entrées et de sorties. Le modèle traite l'entrée et produit les sorties souhaitées, telles que des étiquettes de classification ou la suite d'une invite. La préparation de l'ensemble de données est essentielle.
L'ajustement fin économe en paramètres (PEFT) : l'un des principaux défis liés à l'ajustement fin des modèles de langage à grande échelle (LLM) réside dans leur taille. En règle générale, l'ajustement fin consiste à réentraîner l'ensemble des paramètres du modèle. Le PEFT, quant à lui, ne porte que sur une petite partie des paramètres du modèle. Cela permet de réduire considérablement les besoins en ressources. (DigitalOcean est un exemple d'outil fournissant l'infrastructure nécessaire à l'ajustement fin de votre LLM.)
Pour le réglage fin d'un modèle RoBERTa QA pré-entraîné existant sur des données relatives aux règlements d'urbanisme, j'ai opté pour une approche de réglage fin supervisé.
Pour en savoir plus sur l'entraînement des modèles LLM, consultez la documentation d'IBM, ou pour en savoir plus sur le réglage fin, consultez ce tutoriel de DigitalOcean.
Comprendre les courbes d'apprentissage
Avant de procéder au réglage fin du modèle, il est important de bien comprendre les courbes d'apprentissage. Les courbes d'apprentissage vous aident à évaluer les performances du modèle pendant l'entraînement et à identifier les problèmes potentiels avant qu'ils n'entament ces performances.
Les courbes de perte montrent comment l'erreur (perte) du modèle évolue au fil des étapes d'apprentissage.
Les courbes de précision indiquent le pourcentage de prédictions correctes au fil des étapes d'apprentissage.
Les courbes de perte de validation sont des indicateurs qui évaluent les performances d'un modèle d'apprentissage profond sur un ensemble de données de validation (un ensemble de données que le modèle n'a jamais vu pendant l'entraînement).
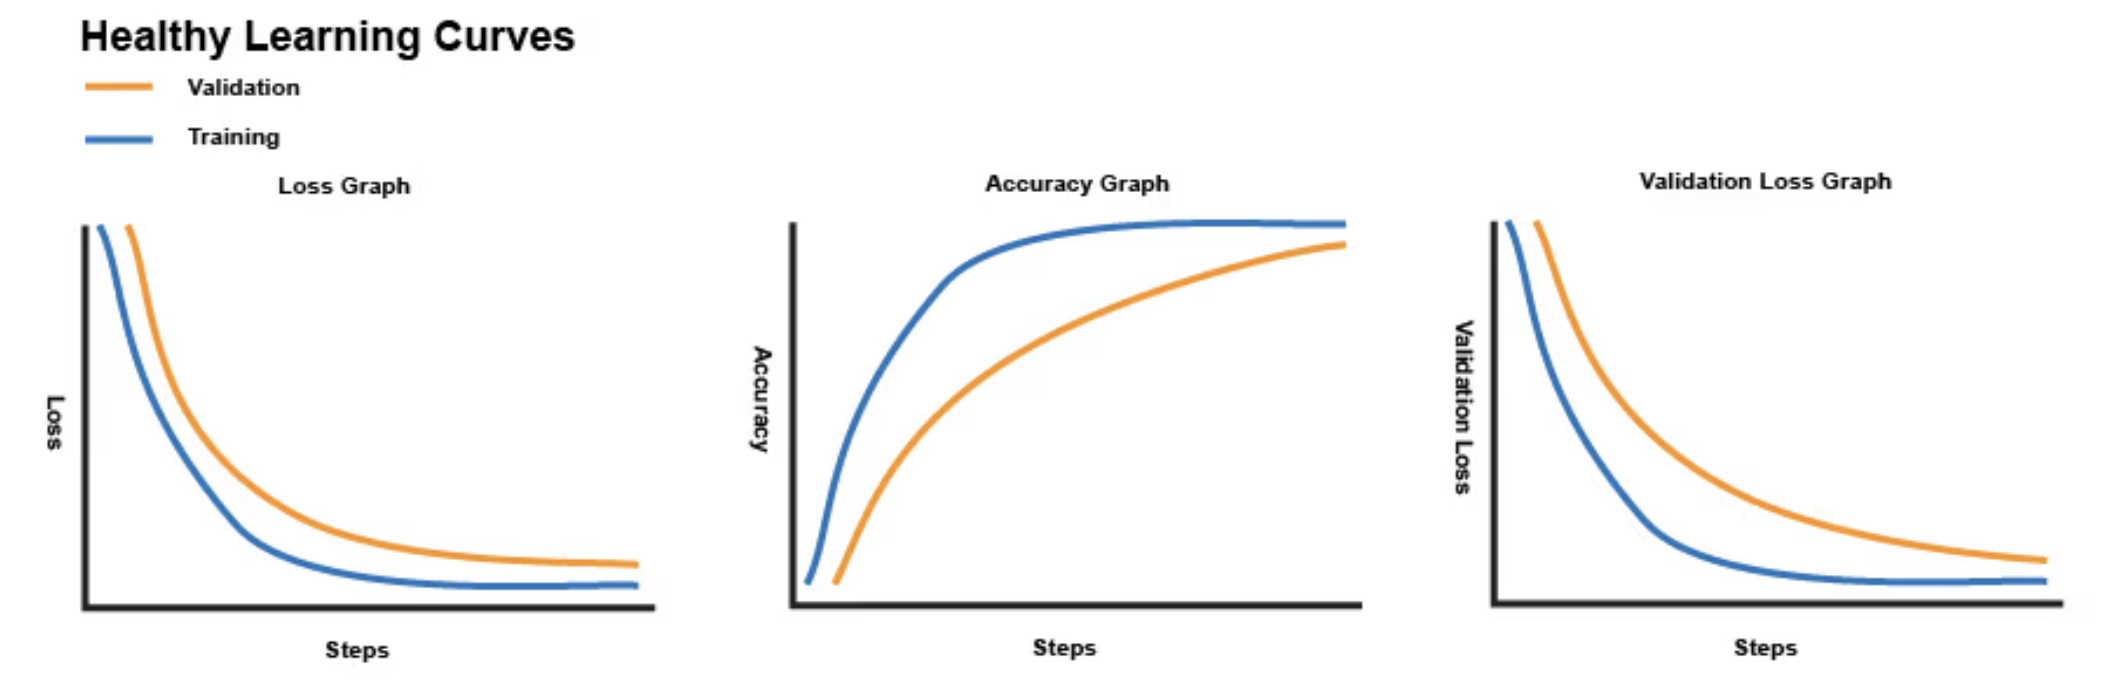
Exemples de courbes de perte, de précision et de validation « saines » représentées sous forme de graphiques.
Le modèle devrait présenter une perte initiale élevée avant l'apprentissage, car les prédictions sont initialement de mauvaise qualité. Au fur et à mesure que l'apprentissage progresse, la perte devrait généralement diminuer. Elle finit par se stabiliser à un niveau faible, à mesure que le modèle apprend à reconnaître les tendances présentes dans les données.
En ce qui concerne les courbes de précision, la précision initiale doit être faible et, à mesure que l'apprentissage progresse, elle doit s'améliorer à mesure que le modèle apprend les tendances des données. Les courbes de précision peuvent présenter des plateaux lorsque le modèle émet des prédictions de plus en plus proches de la réponse souhaitée et correcte.
Pour en savoir plus sur les courbes d'apprentissage, consultez le cours sur les modèles de langage (LLM) de Hugging Face et la fiche de GeeksforGeeks consacrée aux pertes d'entraînement et de validation en apprentissage profond.
Préparation de l'ensemble de données d'apprentissage
Comme mentionné précédemment, la préparation des ensembles de données est essentielle pour le réglage fin supervisé spécifique à un domaine. Les ensembles de données doivent être nettoyés et formatés de manière à pouvoir être traités par le modèle. Pour plus d'informations sur la préparation des ensembles de données, reportez-vous à la partie 2.
Dans le cadre de ce projet, j'ai mené deux expériences de réglage fin et j'ai utilisé un ensemble de données d'apprentissage comprenant respectivement 100 et 500 exemples étiquetés.
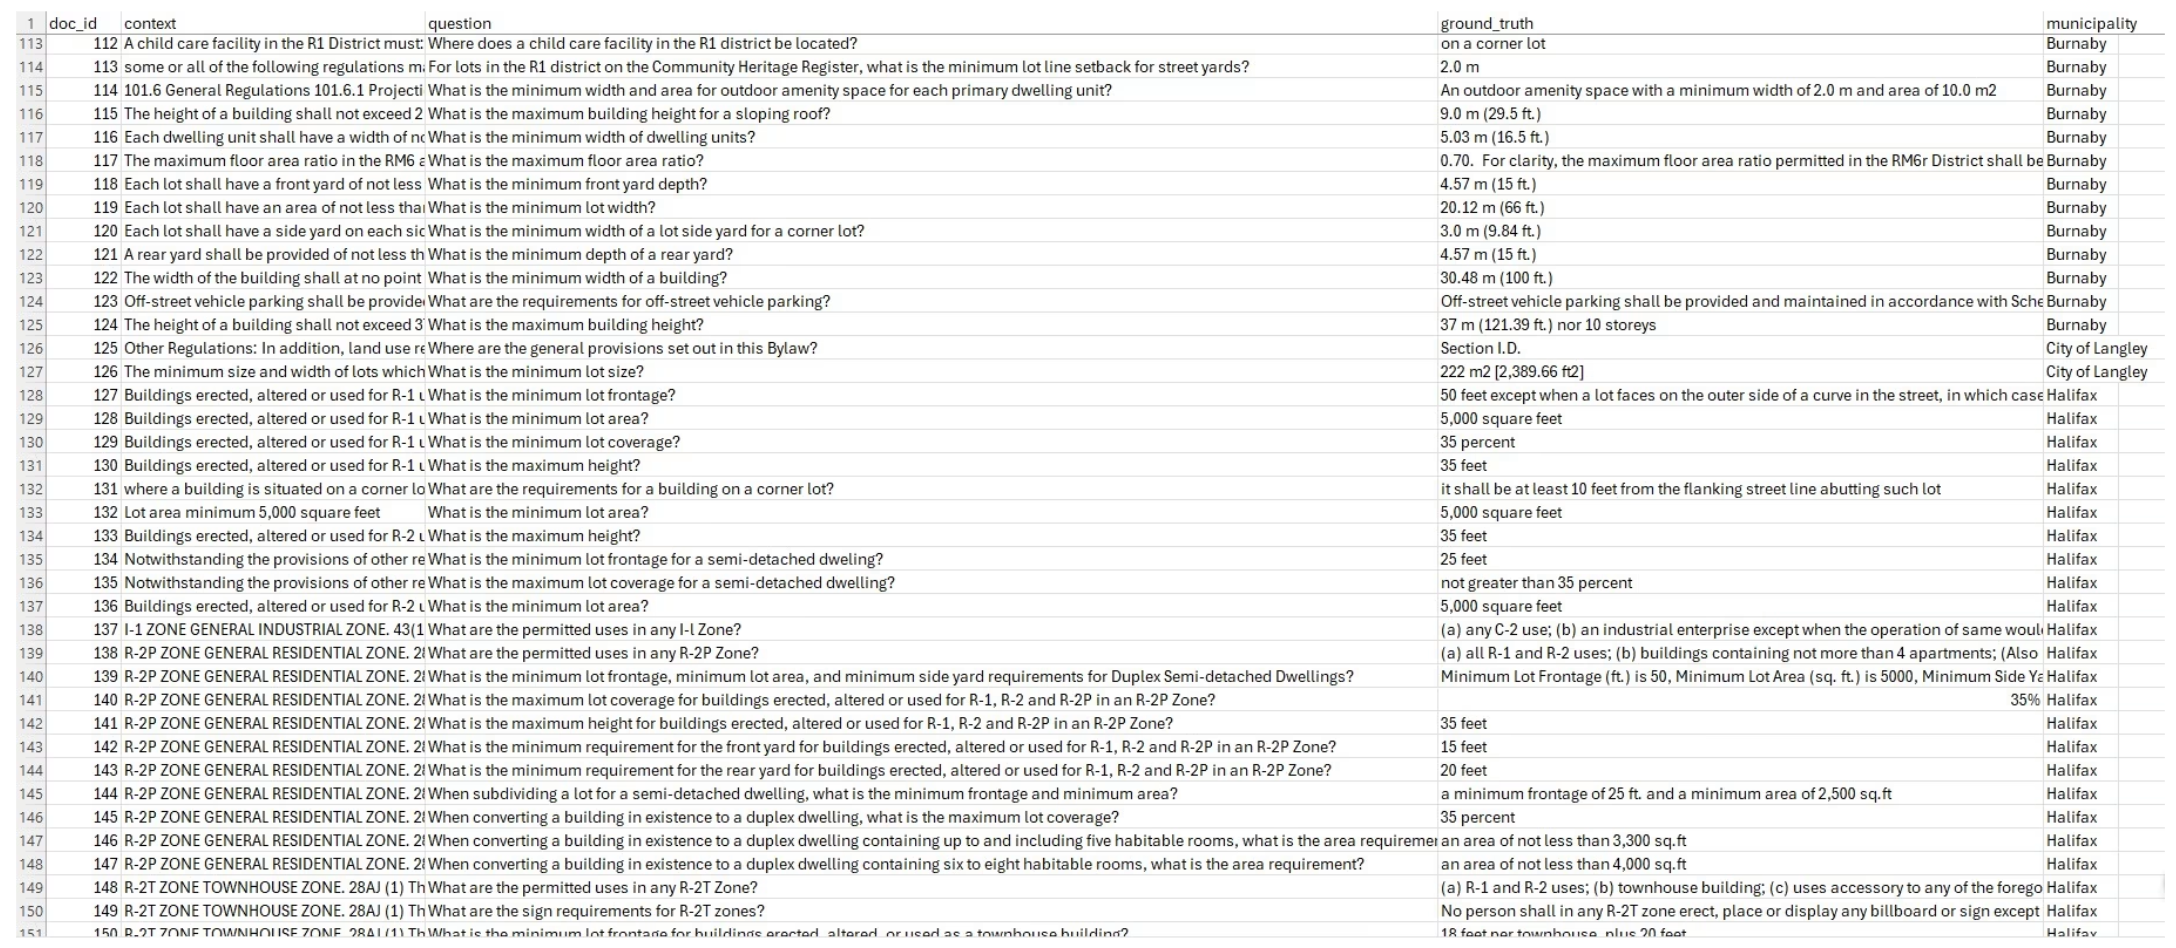
Capture d'écran d'un extrait de l'ensemble de données d'entraînement utilisé.
Quels ont été les résultats de ce réglage fin ?
Vous trouverez ci-dessous une image présentant le récapitulatif des pertes d'entraînement et de validation pour les expériences d'affinage menées sur des ensembles de données d'entraînement de 100 et 500 échantillons.
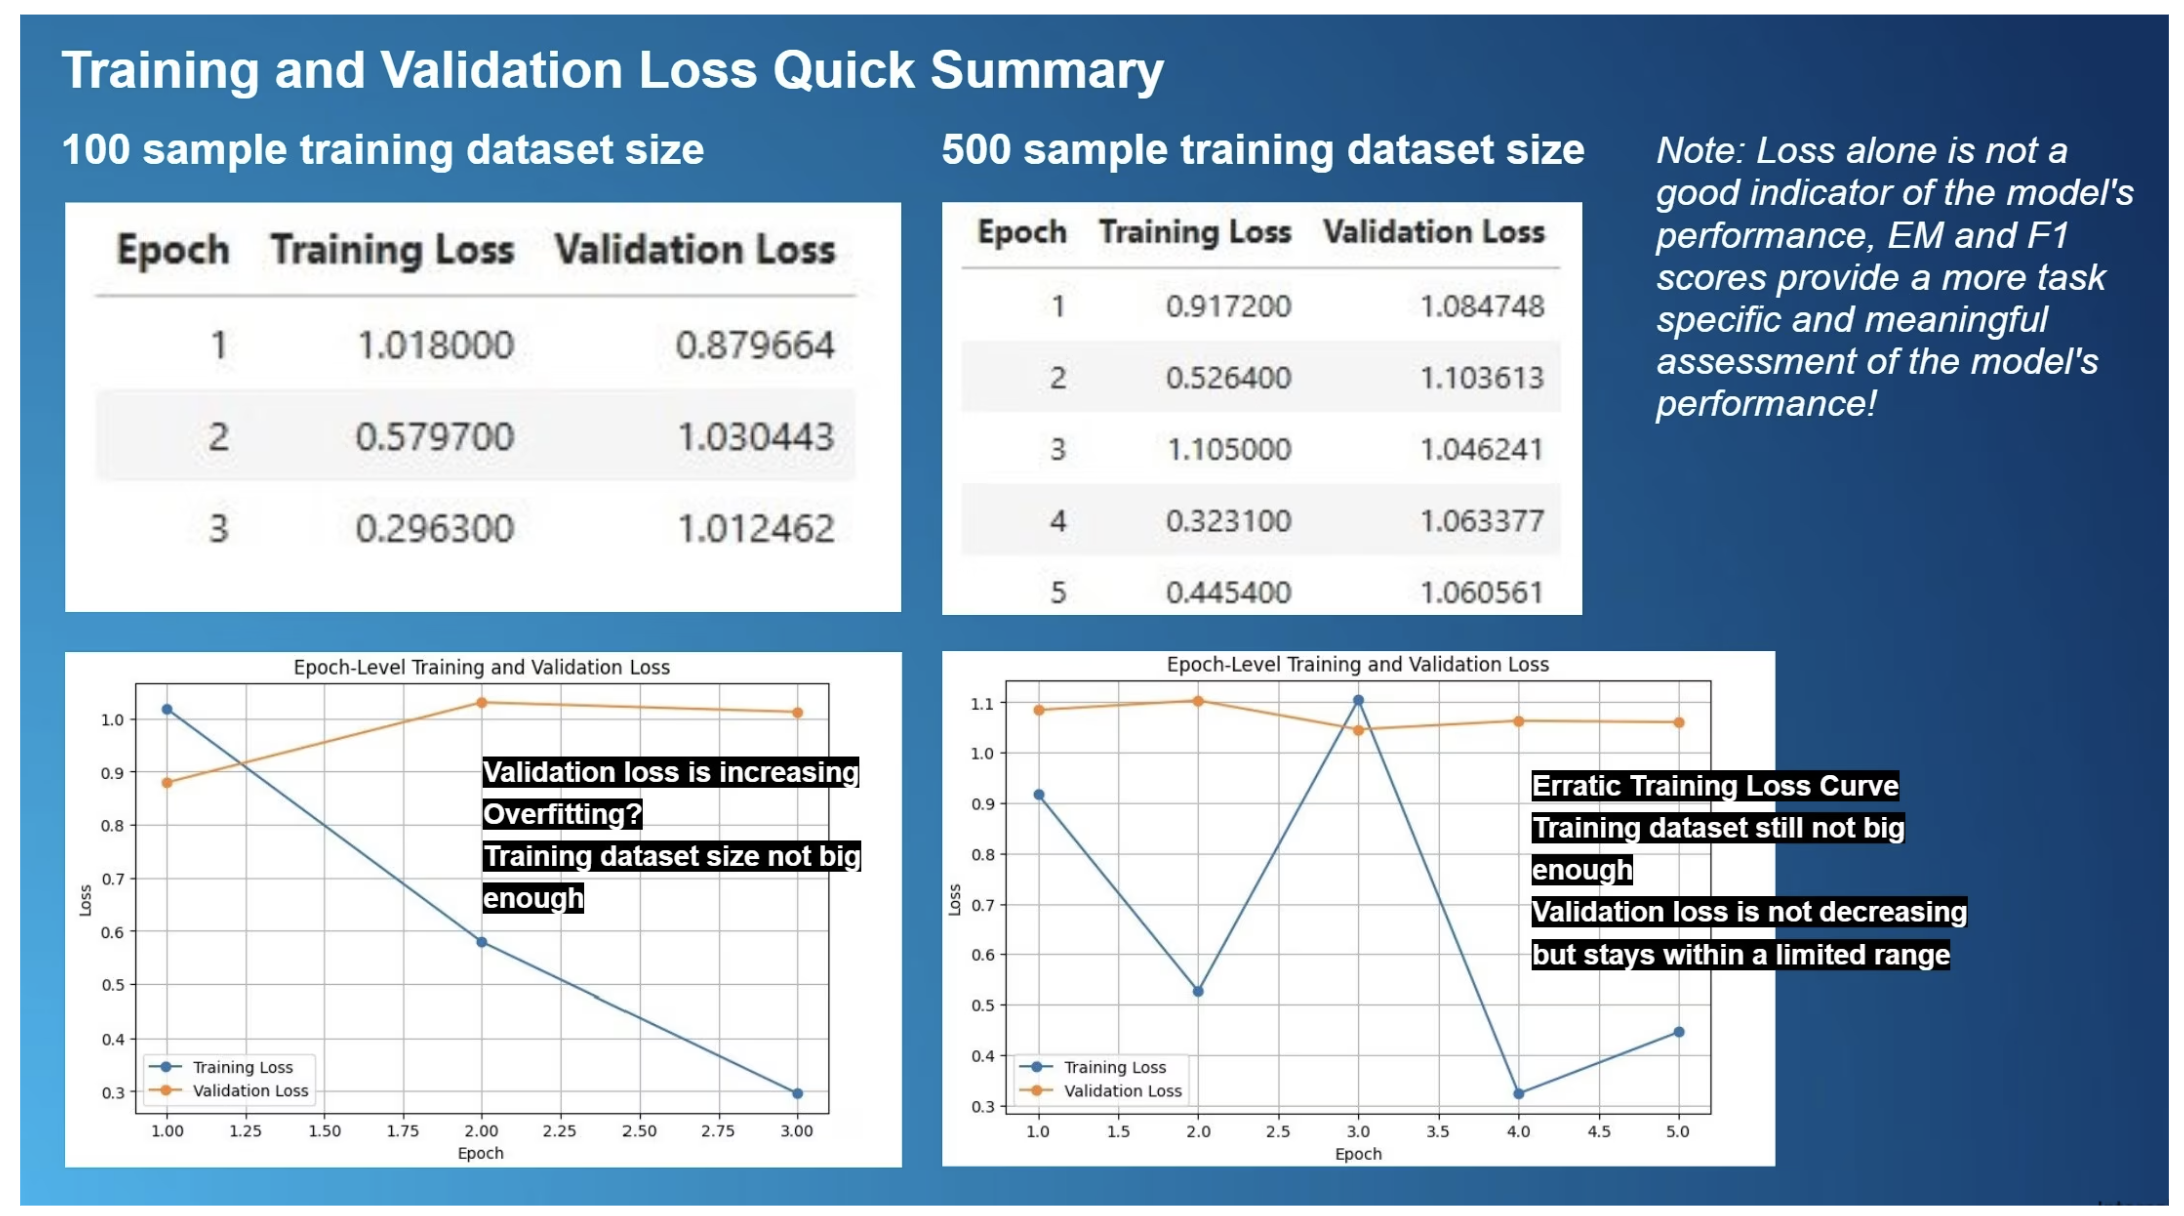
Une image présentant le récapitulatif des pertes d'entraînement et de validation pour les expériences d'affinage menées sur des ensembles de données d'entraînement de 100 et 500 échantillons, que j'ai réalisées dans cet article de blog.
Le tableau ci-dessous présente les scores EM et F1 (pour connaître la signification de ces scores, veuillez vous reporter à la 2e partie de cette série d'articles de blog) des expériences de fine-tuning menées sur des ensembles de données d'entraînement de 100 et 500 échantillons.
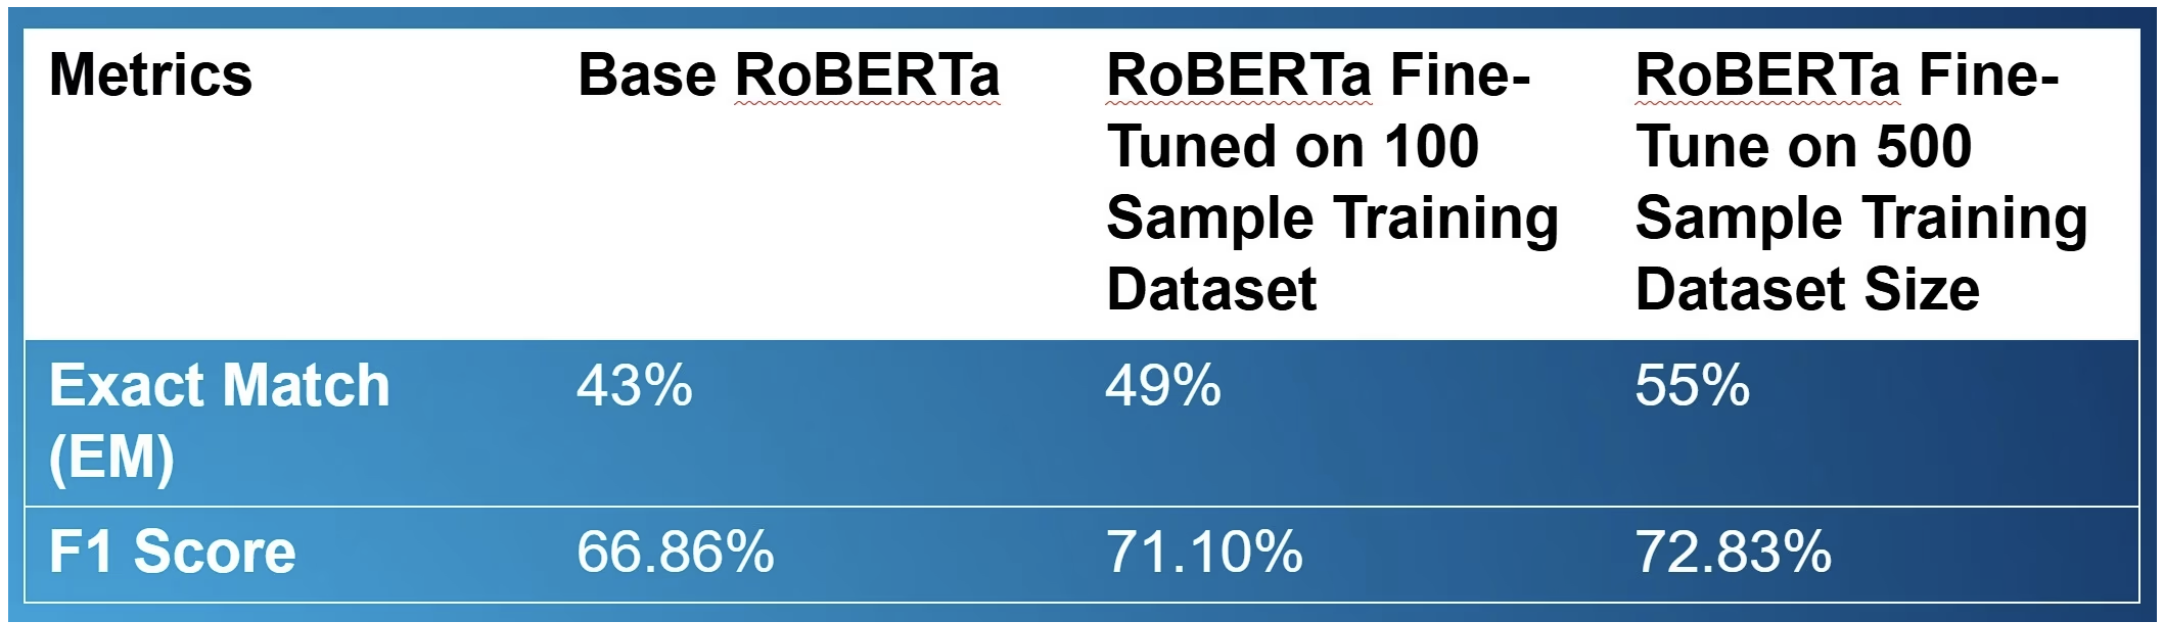
Remarque : la perte seule ne constitue pas un bon indicateur des performances du modèle. Les scores EM et F1 permettent une évaluation plus pertinente et mieux adaptée à la tâche !
Une chose que j'ai découverte en me penchant sur les courbes d'apprentissage, c'est que les tutoriels présentent aux étudiants des exemples idéaux. En réalité, les chiffres relatifs à la perte d'entraînement et à la perte de validation présentent souvent des fluctuations, surtout lorsque les ensembles de données d'entraînement sont de petite taille ! Ne soyez pas surpris si, lors de vos premières expériences, vous avez du mal à interpréter les graphiques et les chiffres.
Dans les deux expériences, la perte d'apprentissage diminue généralement à un rythme stable, à l'exception d'une fluctuation aléatoire et d'une augmentation observées lors de l'époque 3 de l'expérience avec 500 échantillons. En revanche, la perte de validation augmente dans l'expérience avec 100 échantillons et ne s'améliore pas beaucoup dans celle avec 500 échantillons. Elle reste dans la même fourchette. Cela pourrait s'expliquer par la petite taille de l'ensemble de données d'apprentissage.
J'ai appris que la perte, à elle seule, ne constitue pas un bon indicateur des performances du modèle et que les scores EM et F1, en particulier pour la réponse à des questions, offrent une évaluation plus pertinente. Je me suis donc davantage concentré sur ces indicateurs.
Par rapport au modèle de base, l'affinage avec un ensemble de données d'apprentissage de 100 échantillons permet d'obtenir une amélioration de +12 en EM et d'environ +6 en F1. En revanche, avec un ensemble de données d'apprentissage de 500 échantillons, le gain en EM et en F1 n'est que d'environ +1. Entre le modèle entraîné sur 500 échantillons et celui entraîné sur 100 échantillons, on observe des rendements décroissants.
Il semble également qu'après un ajustement, les modèles aient encore du mal à répondre à des questions complexes et ne soient pas en mesure de fournir des réponses comportant de nombreuses conditions et de longues phrases. Vous trouverez ci-dessous une capture d'écran de certaines réponses fournies par le modèle lors de l'évaluation après l'entraînement :
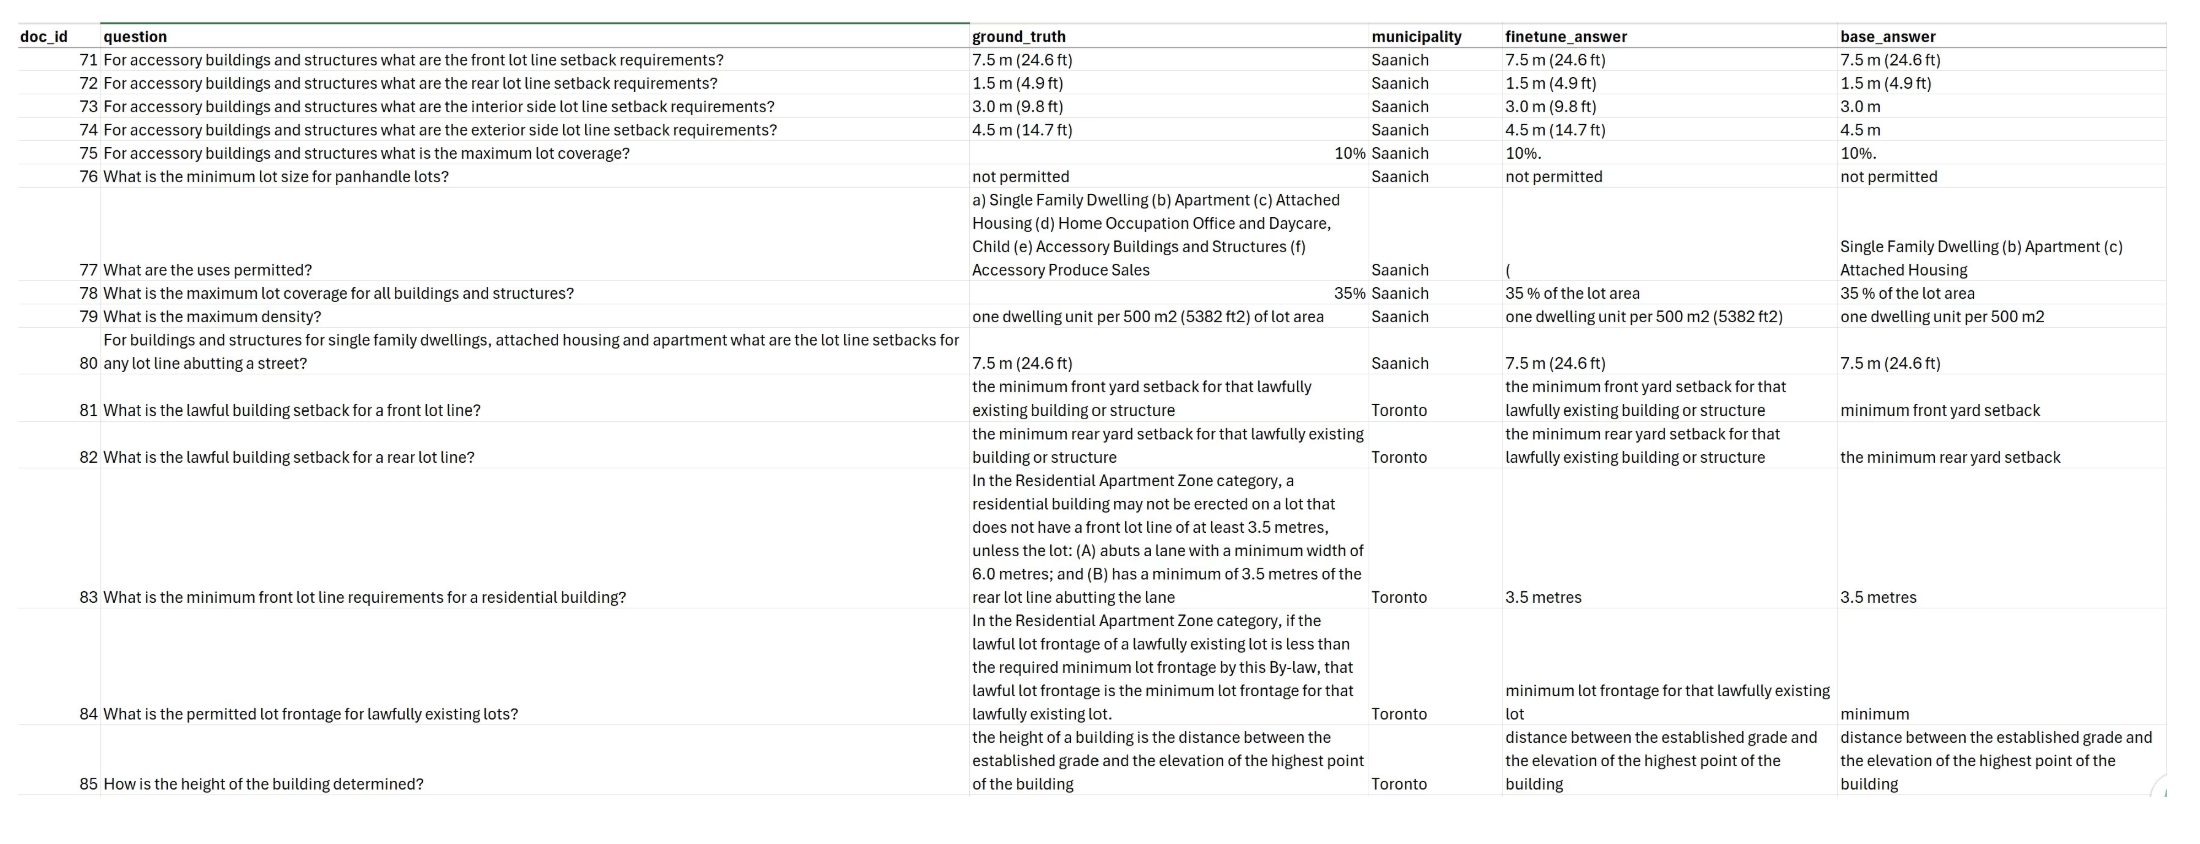
Une capture d'écran de certaines réponses fournies par le modèle lors de l'évaluation après l'entraînement.
Plusieurs raisons peuvent expliquer ce phénomène de rendements décroissants :
- La majeure partie du gain provenait de 100 à 200 exemples de données
- Ce domaine n'est peut-être pas si différent que ça, et il se peut que des ajustements ne soient pas la bonne solution.
- L'ensemble de données n'est pas suffisamment volumineux par rapport à la taille du modèle (ce qui explique le tracé très irrégulier de la courbe de perte d'apprentissage)
- Peut-être qu'un ensemble de données plus varié ou plus complexe permettrait d'aborder des questions plus variées et plus ambiguës, formulées de manière plus subtile (ce qui est peu probable, car j'ai veillé à inclure un bon mélange de questions et de réponses faciles et difficiles).
- Mauvais choix des paramètres d'entraînement/hyperparamètres
Si vous souhaitez consulter le code source et le flux de travail, rendez-vous sur le dépôt GitHub dédié à ce projet.
Réflexions finales
Je pense que la raison pour laquelle la précision du modèle cesse de progresser tient au fait que l'ensemble de données n'est pas assez volumineux par rapport à la taille du modèle. Pour améliorer encore la précision, j'aurais probablement besoin d'un ensemble de données comprenant plus de 10 000 exemples, au lieu des 500 actuels !
Pour résumer tout ce parcours, je considère que ce projet a été une réussite dans la mesure où j’ai beaucoup appris au cours de ce processus, même si je n’ai pas obtenu les résultats escomptés. Si vous vous souvenez bien, dans la première partie, j’avais indiqué que cette série d’articles de blog avait pour objectif de partager mon parcours d’apprentissage en décortiquant des concepts techniques de manière simple et accessible.
Enfin, il est important de garder à l’esprit l’objectif même de l’urbanisme : créer des communautés épanouies pour tous. Un urbanisme de qualité consiste à créer un sentiment d’appartenance et un attachement au lieu. Cela nécessite de trouver un équilibre non seulement entre des facteurs tangibles tels que l’aménagement du territoire, les transports et les infrastructures, mais aussi entre des considérations intangibles telles que la culture, l’identité, l’équité et les valeurs communautaires. Cela requiert de l’empathie humaine, du discernement et une connaissance du terrain. Comme je l’ai montré dans la partie 3 ci-dessus, le modèle n’est pas prêt à être utilisé sans qu’un jugement humain important n’intervienne ; veillez donc à faire preuve de prudence lorsque vous utilisez des modèles de langage grand format (LLM) pour traiter des données de zonage et vérifiez votre travail.
En général, lorsqu'on utilise des outils d'IA…
- Nous devons porter un regard critique sur leurs résultats
- Nous devons être conscients des biais et de la qualité de leurs données d'entraînement et de leurs algorithmes
- Nous devons comprendre les atouts et les limites des différents outils d'IA et des différents types de modèles
- Nous devons évaluer en permanence la précision de ces technologies afin de nous assurer qu'elles permettent d'atteindre les résultats escomptés, en particulier pour les tâches à haut risque et les processus décisionnels.
Nous devons garder à l'esprit que les technologies d'IA sont des outils et que ce sont les humains qui doivent en tenir les rênes.
